预测(监督机器学习)用来预测目标变量。例如,用公寓的面积、位置、设施来预测纽约市的房价。价格是公寓的目标,面积、位置、设施是预测模型的特征。
注意:Tutorial 103提供了一个一步步介绍如何创建和部署一个预测模型。 以下内容假定你已经学习过这个向导。
按以下步骤在DSS中使用监督学习:
- 进入项目中的Flow
- 点击要使用的数据集
- 选择实验室
- 创建可视化分析
- 点击模型Tab
- 选择创建第一个模型
- 选择预测
DSS对三种不同对目标类型支持三种不同对预测类型。
- 回归用来预测数值目标(例如公寓价格)。
- 二分类用来预测目标属于两种类型中的一种(例如门卫在岗还是不在岗)。
- 多分类用来预测目标属于多钟类型中的一种(例如公寓的邻居)。
DSS能创建以上各种分类任务。可选项、算法和结果可能因为不同的分类任务有所不同。
在训练模型时,在“测试集”上预测模型的性能表现是很重要的。在训练阶段,DSS“拿出”测试数据集,只在训练数据集上训练模型。
一旦模型训练完成,DSS会在测试集上测试模型性能。这将会保证模型会在“未知”数据上完成评估。
DSS提供两种策略用来拆分训练和验证数据集。
DSS默认随机将数据拆分为训练数据集和测试数据集。训练数据集的百分比占比可以在DSS中设置,标准是80%。
此外,根据DSS依赖的计算引擎DSS能够随机拆分数据集样本。对于像Scikit-learn/XGBoost这样的内存计算引擎来说尤为重要。DSS默认用数据集中的前100000条。
这种方法的另外一种叫法为“K-Fold cross test”,DSS中也用到了。采用k-fold交叉测试,将会把数据集拆分成相同大小的n个folds。每个fold当作独立的单个测试集,剩下的n-1个fold当作训练集。这种方法会大大增加训练时间(粗略来说是n倍)。但是这However, it allows for two interesting features:
- 它提供来准确度更高的模型,通过“error margin”性能指标,在启用来K-Fold交叉验证后,所有的性能指标将会有更好的容错能力。
- 一旦在每个fold上评分后,DSS可以用100%的数据集重新训练模型。在没有足够多训练数据的情况下这是很有帮助的。
通常来说如果数据分布是均衡的就可以用随机拆分来拆分数据。
DSS也支持用户显式指定训练集和测试集。如果数据是结构化数据,例如不同城市的公寓价格,就可以用数据结构来指定训练和测试数据集。
显式提取既可以是单个数据集也可以是不同的数据集。每种提取可以这么定义:
- 过滤规则
- 抽样规则
也可以用拆分Recipe的输出作为显式提取。比起内置的随机拆分组建,拆分Recipe对控制如何拆分数据集更强大。
总体上,如果数据分布很有特点就可以用显式提取。
注意:在“显式提取”模式下因为已经提供来预定义的训练和测试数据集,所以不会使用K-Fold交叉验证
模型是通过选择的评估指标进行优化的,评估指标在交叉验证(参见训练和验证)和超参grid search(在参数列表中指定可能的算法参数)中用来做模型评估。
对于二分类问题,通过选择的评分指标来优化目标分类的可能性阈值。
参见特征处理
注意:在模型 > 设置 > 特征生成下面改变特征生成设置
DSS用线性或者多项式合并来计算变量之间的关联。生成的特征通过线性方法例如线性回归检测变量和目标之间的非线性关系。在这种场景下生成特征可以提高模型性能。
注意:在模型 > 设置 > 特征降维下面改变特征降维设置
对特征进行降维通过降低模型的纬度空间正则化模型和提高模型解释性。
- 目标关联:选取与目标关联度(Perason)最高的特征,可以设置关联度最小绝对值阈值。
- Tree-based:创建一个随机森林来预测目标,通过特征重要性选择重要性最高的特征。
- 主成分分析(PCA):用PCA对特征降维,只会选取主要的成分纬度。注意:这种方式会生成不可解释的特征输出。这种模- 型的效果可能会好,但是可解释性差。
- 岭回归:创建LASSO模型,用3-fold交叉验证选择最好的正则化值。只选取非零系数的的特征。
注意:在模型 > 设置 > 算法中修改特征生成设置
DSS支持多种算法训练预测模型。我们建议尝试多种算法后再选择具体模型做预测。
算法依赖与计算引擎,详情参考机器学习引擎
每个机器学习算法都有一组参数设置,叫做超参。
DSS中可以给每种算法设置不同的值。例如:对回归算法可以设置不同对正则化参数。
DSS自动尝试设置对每个值然后保留最好对一组值。这个过程就是超参优化或者“grid search” 为了选择最好对参数,DSS重新拆分多组交叉验证训练数据集。然后在训练集上重复训练,在验证集上验证模型性能表现。
在超参优化过程中,DSS不会使用测试集,它会被保留做最终模型评估。
可以对以下参数进行调优
有多种策略选择交叉验证集
这种方法把训练数据集拆分成“真实训练”和“交叉验证”数据集。对于每组超参DSS都会训练模型并计算评估指标,保留评估指标最好对超参。
这种方法对明显缺陷是限制DSS中训练对数据集大小,同时也会因为分割的特点带来不确定性。
用这种方法把训练集拆分成n个等大小的folds部分。DSS在每个fold上选取超参的平均值。DSS选择在评估指标上最好的超参,然后在整个训练数据集上训练模型。
这种方法增加来训练时间(大概是n倍)但是可以在整个训练集上进行训练(因为是有多个评估指标结果所以也降低来不确定性)
注意:K-Fold交叉验证是在交叉验证集上优化超参的一种方法。
不要与K-Fold交叉测试混淆,后者用于通过测试集在最终评分上评估错误边界。
注意:只有在“Python内存”训练引擎系才适用
如果你用skikit-learn或者XGBoot,你就可以提供自定义交叉验证对象。交叉验证对象必须遵循skikit-learn的交叉验证协议。
参见:http://scikit-learn.org/stable/modules/cross_validation.html
如果你选择来很大的超参进行优化,训练就会很慢。
在DSS做grid-searching的任何时间都可以中断优化。DSS会完成当前搜索点并在“截止到当前最好的超参”上训练并验证模型。
我们建议启用“随机 grid search” 如果计划中断grid search。
grid search中断后可以后续恢复。DSS会自动训练还未尝试过的超参。
如果在的SS中选择多组超参,那么在训练过程中DSS将会以图形化显式到目前为止最好的交叉验证分数。DSS只会显式到当前最好的评分,即使后续的模型评估会有更好的评分。如果把光标移到其中一个点上,将会看到整个优化进化过程中的超参值。
在右边的图表上,会看到最终模型的测试评分(模型grid-search阶段结束后)
X轴上的时间表示特定算法的训练时间。DSS并不是同时开始训练所有的模型,但是每个算法的X轴都会从零开始。
完整一次训练
注意:在图表的左边部分看到的评分是在交叉验证集上交叉验证得到的,是不能跟右边看到的测试评分直接比较。
- 它们不是在同一数据集上计算的
- 它们不是由同一模型计算得到的(在grid-search之后,DSS会在整个数据集上重新训练模型)
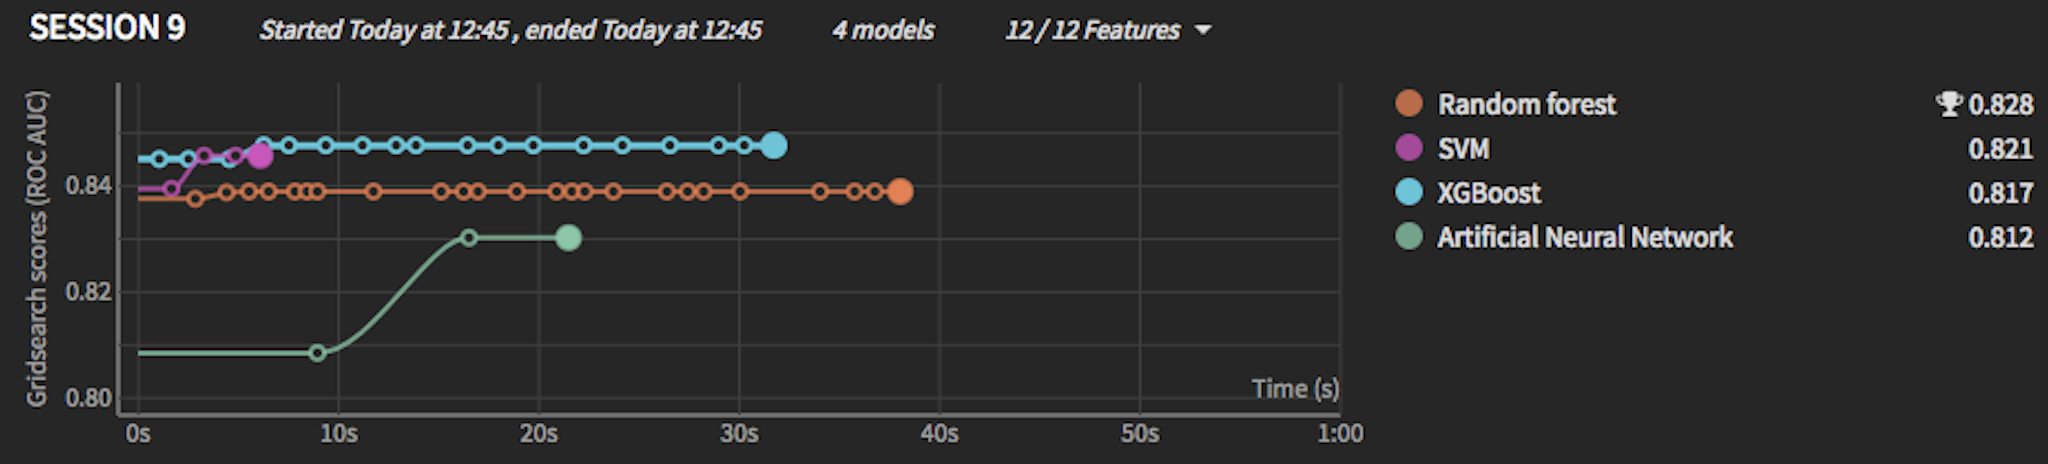
在这个例子中:
- 尽管XGBoot比随机森林在交叉验证集上有更好的表现,但是最终随机森林(这可能是由于RF在交叉验证集上没有足够多的数据集)在测试集(在整个数据集上训练)上更好。
- ANN在交叉验证集上得到0.83分,但是最终测试集上只有0.812分
当模型训练结束,可以看到每个超参值对最终评分和训练时间的影响。可以导出报告的图表或者表格。
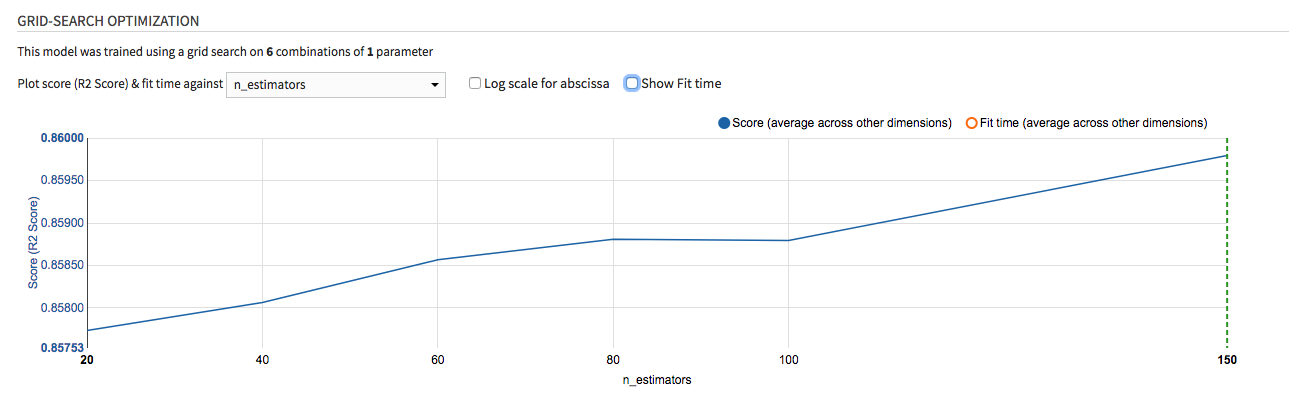
在DSS中可以选择模型评估的指标。
在进行超参优化时用评估指标决定哪个模型是最优的。
为了在测试集上显式,将会默认显式在主要评估指标上测试的结果,DSS会对所有指标进行评估,所以可以选择显式在哪个评估指标上的结果(但是,如果切换来评估指标,将不能保证选择的超参在新的评测指标上也最好的)
在做二分类时,多数的模型的不会直接输出一个单一的二分结果,二十一个连续的“正值可能性”。需要在可能性上选择一个阈值,对大于这个阈值对样本DSS认为它是正值。
在比较假正类和假负类时优化阈值就是一个平衡问题。
DSS会在多个阈值上计算真正、真负、假正、假负(混淆矩阵)然后在评测指标上选择合适的阈值。
也可以在任何时间在结果显式上设置阈值
DSS不能处理很大的分类。我们建议不要对超过50个分类做机器学习分类。
你需要保证在创建机器学习任务时所有对分类都会被检测到。样例分析脚本会检测所有的可能的分类,所以要保证样例中要至少要包含不同分类的一条记录。如果有分类记录没有出现在样例中而出现在算法训练填充时,训练将会失败。
而且,需要保证所有的分类出现在训练和测试数据集中。可能需要通过调整数据拆分设置来保证。
请注意这些限制在处理很大分类的时候会变得复杂。